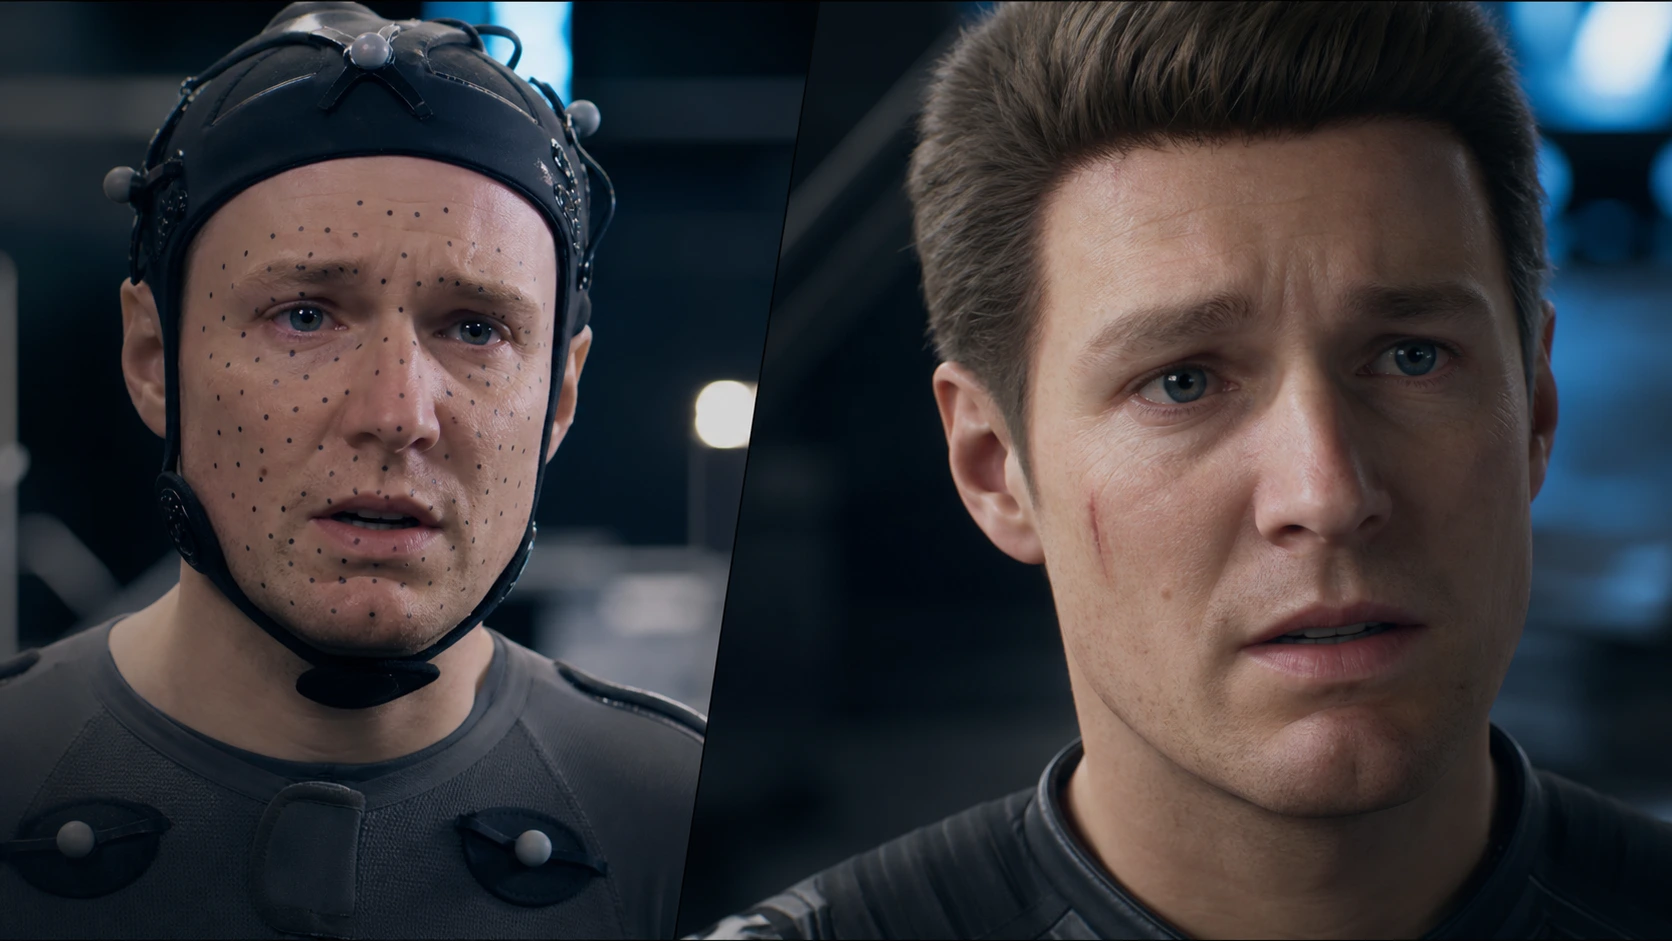
Llevo años integrando IA en mis flujos de trabajo, desde el concepto hasta la postproducción, pero lo que Meta está haciendo con los avatares de vídeo de Muse me obliga a repensar la naturaleza de la performance digital.
No se trata solo de un «talking head» generado por IA. La capacidad de dotar a un agente de una identidad visual coherente, que no solo hable sino que gesticule con una intención ligada a la tarea que está ejecutando, es un salto cualitativo. En mis proyectos de publicidad para lujo, la precisión del lenguaje no verbal lo es todo. Hasta ahora, lograr esa precisión requería horas de captura de movimiento o un trabajo exhaustivo de animación frame a frame.
Si un agente puede gestionar mi correo o controlar mi Mac mientras mantiene una presencia visual humana y convincente, estamos pasando de la herramienta al «colaborador visual». Imagino esto aplicado a la previsualización: poder interactuar con un agente que no solo me explique la escena, sino que me la muestre actuando el rol del director de fotografía o del actor, en tiempo real.
Sin embargo, veo un riesgo claro: la homogeneización del gesto. La IA tiende a promediar. El cine vive de la imperfección, del tic nervioso, de la pausa incómoda. Si delegamos la performance a modelos preentrenados de Meta, corremos el riesgo de entrar en un valle inquietante no por la falta de realismo, sino por el exceso de perfección sintética.
En mi flujo actual, uso herramientas de generación de vídeo para prototipar, pero la dirección sigue siendo humana. El reto ahora es cómo dirigir a estos avatares. No quiero que «parezcan humanos», quiero que transmitan una emoción específica que yo, como director, haya decidido.
Al final, la tecnología es el pincel, no el artista. Los avatares de Muse son una pieza técnica formidable, pero el sentido dramático sigue siendo territorio humano.
Fuente original: The Decoder